1. 一句话结论
主指标是人工 Elo。像素类指标只是辅助。所有指标都没有及格线。仓库里没有任何评测代码。
| 项 | 状态 |
|---|---|
| 主指标 | 人工两两比较 → Bradley–Terry → Elo |
| 辅助指标 | 与参考视频比的像素/特征指标 |
| 及格线 | 无(只有评分员资格线 8/10) |
| 评测代码 | 无 |
| 原始人工判断 | 未公开 |
| 消融实验 | 无 |
2. 人工指标
20 名众包评分员。共 361 次有效两两判断。每个模型约 51 次。评分员一次点击,同时判三条:贴合文字、运动自然、物体恒存。
评分员很可能看了参考视频。§1 第 2 页写明:"Generated continuations are judged by human evaluators against physically consistent, hand-authored animation ground truth"。§4.4 第 9 页只写了 "the input video and the text prompt" 和 A/B 两段。所以 §4.4 的描述不完整。评分说明没有公开。
| 指标 | 测什么 | 怎么算 | 越高还是越低好 |
|---|---|---|---|
| Elo | 人更偏好哪个模型 | 选 A / B / 差不多;平局算半胜;Bradley–Terry 拟合;均值 1500 | 越高越好 |
| 95% CI | Elo 的不确定性 | 按评分员重抽样 1000 次 | 越窄越确定 |
| Score rate | 原始胜率 | 胜 = 1,平 = 0.5,除以场次 | 越高越好 |
| Games | 参加的判断次数 | 计数;每个模型 50–52 | — |
| Top-1 概率 | 排第一的机会 | 1000 次重抽样里排第一的比例 | 越高越好 |
| 分族 Elo / 排名 | 单个任务族上的偏好 | 每族单独拟合;每族 36–96 场 | Elo 越高越好;排名 1 最好 |
经验值(Elo):标准 Elo 用 400 尺度。预期得分 = 1/(1+10^(−d/400))。差 100 分约 64%。差 200 分约 76%。WROP 的 1500 是均值。WROP 用 Bradley–Terry 拟合。换算系数没公开。下面的换算假设标准 400 尺度。例:PWM-WROP 比 Grok Imagine 高 222.5 分,约 78%。Wan 3.0 Prime 比 PWM-WROP 高 44.1 分,约 56%。出处:Wikipedia: Elo rating system
| 评分员质检 | 数 |
|---|---|
| 资格测试 | 及格线 8/10 |
| 注意力检查 | 90.0% 正确 |
| 重复题自洽 | 93.5%,Cohen's κ = 0.891 |
| 左右位置偏差 | 左边胜 51.4%(p = 0.615) |
3. 自动指标
模型输出先按各模型规则裁剪。再均匀重采样到 60 帧。再缩到 320×192。然后和参考视频逐题比。最后对 300 题取平均。论文自己说:这些指标只测「像不像参考」,不测物理推理对不对。
| 指标 | 测什么 | 怎么算 | 越高还是越低好 | 报了吗 |
|---|---|---|---|---|
| MSE | 像素平方误差 | 320×192 | 越低越好 | 表 3 |
| MAE | 像素绝对误差 | 320×192 | 越低越好 | 算了,未报 |
| PSNR | MSE 的对数形式 | 320×192 | 越高越好 | 表 3 |
| SSIM | 局部结构相似 | 320×192;窗口未写 | 越高越好 | 表 3 |
| MS-SSIM | 多尺度 SSIM | 320×192 | 越高越好 | 表 3 |
| LPIPS | 感知距离 | 320×192;骨干网未写 | 越低越好 | 表 3 |
| 时间差 L1 | 帧间变化是否一致 | 公式未写 | 应为越低越好 | 算了,未报 |
| 末帧 MSE / SSIM / LPIPS | 只比最后一帧 | 320×192 和 1280×720 | MSE、LPIPS 越低越好;SSIM 越高越好 | 算了,未列表(正文只给 PWM-WROP 末帧 LPIPS 0.166) |
| CLIP | 语义相似 | ViT-B/32,224×224;定义未写 | 越高越好 | 表 3 |
| FID | 生成帧与参考帧的分布距离 | 299×299;每 2 帧取 1;每边约 9030 帧;每个模型只有一个数 | 越低越好 | 表 3 |
经验值(只供参考;最后一列是我们打开读过的出处)
| 指标 | 经验值 | 对眼睛意味着什么 | WROP 表 3 范围 | 出处 |
|---|---|---|---|---|
| MSE | 无通用阈值。PSNR = 10·log10(MAX²/MSE)。 | 要换算成 PSNR 再看 | 2.97–40.59(×10⁻³) | Wikipedia: PSNR |
| PSNR | 8 位有损压缩常见 30–50 dB。无线传输可接受约 20–25 dB。「>40 几乎看不出、30–40 好、20–30 看得出、<20 差」是常见说法,未找到可靠出处。 | 越高,像素差越小 | 15.03–27.51 dB | 同上 |
| SSIM / MS-SSIM | 取值 −1 到 1。1 = 完全相同。0 = 不相似。无公认阈值。 | 越接近 1,结构越像 | SSIM 0.768–0.942;MS-SSIM 0.594–0.921 | Wikipedia: SSIM |
| LPIPS | 0 = 相同。无公认阈值。原论文说:模糊让人眼差别大,但 L2 变化小;SSIM 不是为几何形变设计的。 | 越低,越接近人眼感觉 | 0.081–0.349 | Zhang et al. 2018 |
| FID | 无绝对标准。只在同一协议内可比。原论文:干扰越强,FID 单调升高。原论文用 50,000 张图;WROP 每边约 9,030 帧。 | 越低,整体分布越接近 | 13.6–73.7 | Heusel et al. 2017 |
| CLIP(ViT-B/32) | 无标准阈值。CLIP 用余弦相似度。 | 只反映语义像不像 | 0.853–0.962(挤在 1 附近) | Radford et al. 2021 |
MSE 与 PSNR:论文没写 MAX。按表 3 的量级推断 MAX = 1(像素归一到 0–1)。若 MAX = 255,PSNR 会是 62–73 dB,与表 3 不符。
核对:14 个模型都满足「表 3 PSNR 高于用平均 MSE 算出的 PSNR」,高 1.1–7.1 dB。例:Wan 3.0 Prime 表 3 为 27.15 dB;用平均 MSE 4.48×10⁻³ 算是 23.49 dB。这提示 PSNR 是先逐段算、再取平均(推断)。
注意:这些经验值假设「同一画面加了失真」(压缩、噪声)。WROP 里候选和参考在时间和位置上都会不同。所以这些数只能比模型,不能读成「看起来多像」。例:G26 冻结最后一帧什么都没做,PSNR 仍有 27.22 dB(我们的复算,MSE 1.90×10⁻³)。这高于无线传输「可接受」的 20–25 dB,但它答错了。
考题元数据里还有一个规则判分器的接口(PermanencePhysicsEvaluator,300 题中 276 题有)。代码没公开。论文没提。没有结果。
4. 主要结果
头条指标是人工 Elo(表 2,第 10 页)。前四名的置信区间互相重叠。第一名是统计上的并列。
| 名次 | 模型 | 类型 | Elo | 95% CI | Score rate | Games |
|---|---|---|---|---|---|---|
| 1 | Wan 3.0 Prime | Reference-to-video | 1723.6 | [1629.2, 1864.9] | 77.9% | 52 |
| 2 | MiniMax H3 | Reference-to-video | 1723.6 | [1644.5, 1837.6] | 77.9% | 52 |
| 3 | PWM-WROP | True continuation | 1679.5 | [1603.5, 1781.5] | 73.1% | 52 |
| 4 | Seedance 2.5 | Reference-to-video | 1649.6 | [1554.2, 1751.5] | 69.6% | 51 |
| 14 | MAGI-1 24B | True continuation | 1248.0 | [1137.2, 1315.6] | 19.2% | 52 |
| 其他 | 数 |
|---|---|
| Top-1 概率 | Wan 3.0 Prime 46.8%,MiniMax H3 36.4%,PWM-WROP 12.3%,Seedance 2.5 4.5%,其余 0 |
| PWM-WROP 自动指标 | LPIPS 0.081、MS-SSIM 0.921,两项都是最好 |
5. G26 例子
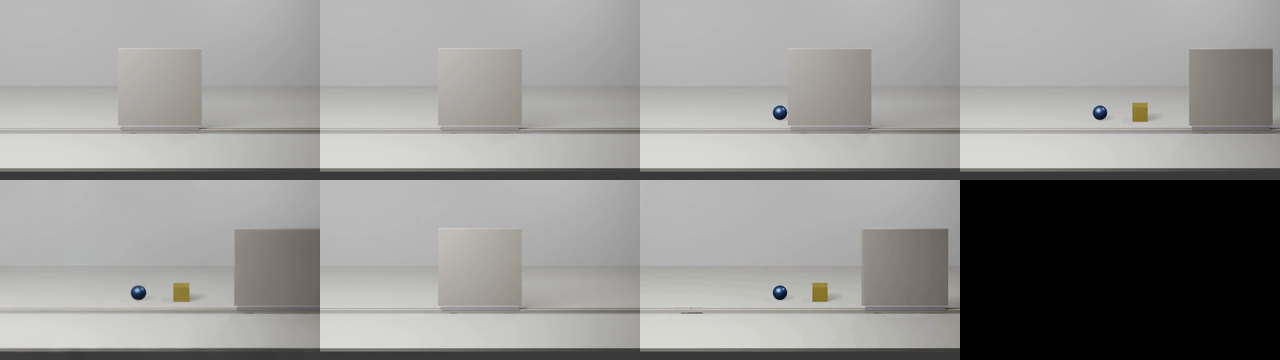
题目:G26 bottom_rail_screen_0000。输入结尾时屏风挡住物体。参考视频里屏风滑回右边,藏青球和黄色方块重新出现。
下表是我们自己的复算。只算了这一题。不是作者的代码。
| 候选 | 最后一帧 | MSE ×10⁻³ ↓ | PSNR ↑ | SSIM ↑ | 末帧 MSE ×10⁻³ ↓ |
|---|---|---|---|---|---|
| PWM-WROP | 球和方块回来了 → 对 | 0.42 | 33.79 | 0.970 | 0.81 |
| Grok Imagine (extend) | 球和方块回来了 → 对 | 0.66 | 31.83 | 0.972 | 0.53 |
| Gemini Omni Flash 1.1 | 屏风一直挡着 → 错 | 3.84 | 24.15 | 0.928 | 5.09 |
| 基线:冻结最后一帧 | 屏风一直挡着 → 错 | 1.90 | 27.22 | 0.961 | 4.98 |
| 基线:复制输入视频 | 不出现揭开 → 错 | 3.79 | 24.21 | 0.932 | 4.98 |
冻结最后一帧什么都没做。它的 SSIM 是 0.961。这高于表 3 里所有模型 300 题平均 SSIM 的最高值 0.942。只有一题,所以这是示例,不是全基准结论。
末帧 MSE 能分开对错。答对的在 0.53–0.81。答错的都约 5.0。论文没有列出这个指标。
6. 主要问题
- 人工协议写得不全。 §4.4 没写评分员看了参考视频。评分说明、界面、截图都没公开。一次 A/B 点击同时判三条,恒存和贴合文字、画质分不开。142/197 个提示词已写出答案,所以「贴合文字」这一条部分在奖励照着文字演。
- Elo 的数据少,且未公开。 只有 361 次判断,每个模型约 51 次。用了哪些考题没写。300 题里多数可能没人评过。前四名置信区间重叠。原始判断、Elo 换算系数、拟合代码都没公开。
- 自动指标能被钻空子。 冻结一帧就能拿高 SSIM。Reference-to-video 模型按自己的时间线重生成,再被硬拉到 60 帧比。对恒存更敏感的指标(末帧、时间差 L1、MAE)算了却没列表。
小的不一致:正文和表 2 对不上(Grok 区间 1368 对 1362.7;LTX-2.3 Extend 1452 对 1453.4;MAGI-1 24B 1240 对 1248.0;领先 224 对 222.5);14 个模型只有 91 对,正文写 120 对;FID 分辨率前后说法不一。
7. 改进建议
- 把协议写明。 写清评分员看到什么:输入 → 参考视频(标「正确结果」)→ 一个候选。公开评分说明和界面。
- 每题问 3–5 个是/否问题。 问题从每题的预期结果标记生成。G26 的例子:屏风走后是不是 2 个物体?颜色不变吗?位置不变吗?有没有东西穿过屏风?有没有揭开?加「看不清」选项。让评分员忽略时间先后、机位和分辨率。
- 加对照。
| 对照 | 预期 |
|---|---|
| 参考视频本身当候选 | 约 100% 通过 |
| 冻结最后一帧当候选 | 揭开类问题不通过 |
| 重复题 | 测前后一致 |
| 不给提示词的一组 | 测提示词当答案的影响 |
- 按通过率计分。 先算每题,再按出题器平均,再按任务族平均。
- Elo 降为辅助。 两两比较只作「整体质量」参考。
评论 0
选中正文里的文字。点「评论」按钮。评论会贴在那段文字上。
无需登录。任何人都可以回复、编辑、删除、解决任何评论。昵称可不填,会记在本浏览器里。
还没有评论。